1 — Install, Headroom, 모델 호출 전에 에이전트 컨텍스트를 압축합니다
Headroom은 도구 출력, 로그, RAG 청크, 파일, 대화 기록을 LLM으로 보내기 전에 사용자 기기에서 먼저 압축해, 줄어든 컨텍스트와 절약한 토큰 수를 돌려줍니다.
코딩 에이전트가 긴 로그와 반복되는 JSON 도구 결과, 커다란 조회 파일을 다음 모델 호출에 통째로 실어 보내려는데 정작 답을 내는 데는 그 분량이 대부분 필요 없을 때 개발자가 이 도구를 씁니다.
반복되는 JSON과 로그는 크게 줄고 산문체는 거의 줄지 않으며, 원본 텍스트는 나중에 다시 꺼내 쓸 수 있도록 로컬 기기에 그대로 남습니다.
없을 때와 있을 때
Headroom이 없으면 에이전트는 도구 결과를 받은 그대로 모델에 넘깁니다. 문서에 나온 로그 예시에서는 10,144토큰짜리 로그 덤프를 통째로 보내고, SRE 장애 디버깅 시나리오에서는 67번 항목의 FATAL 줄과 주변의 겹치는 컨텍스트까지 합쳐 프롬프트가 55,957토큰에 이릅니다.
Headroom을 켜면 같은 로그가 1,260토큰으로 줄어 전송되면서도 FATAL 줄은 그대로 찾아냅니다. SRE 프롬프트는 24,340토큰으로 줄어들고 67번 항목의 FATAL 줄은 손대지 않은 채 남습니다. 모델은 이렇게 짧아진 프롬프트로 답을 내고, 원본 전체가 필요할 때는 로컬에 보관된 텍스트를 다시 요청해 받아 볼 수 있습니다.
무엇을 어떻게 판단할까
Headroom은 모든 메시지를 똑같이 고쳐 쓰지 않습니다. 도구 메시지와 어시스턴트 메시지는 압축하고, 사용자 메시지는 compress_user_messages=True를 넘기지 않는 한 그대로 둡니다. CacheAligner는 프로바이더의 키-값(KV) 캐시 접두사를 깨뜨릴 수 있는 가변 콘텐츠만 표시할 뿐 프롬프트를 다시 쓰지는 않습니다. CCR은 나중에 headroom_retrieve 호출로 꺼내 볼 수 있게 원본 텍스트를 로컬 캐시에 저장합니다. Python 라이브러리 경로는 인프로세스로 동작해 API 키나 모델 다운로드가 필요 없으며, HEADROOM_OFFLINE=1을 설정하면 네트워크 없이 실행하도록 강제합니다. 반환되는 결과 객체에는 절약한 토큰 수와 압축률이 담깁니다.
콘텐츠 유형에 따라 어떤 압축기를 쓸지 고릅니다. 고정된 순서를 거치는 게 아니라 아래 분기로 결정합니다.
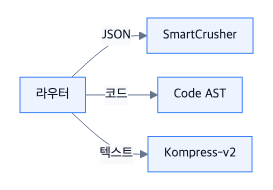
절감 폭은 내용이 얼마나 반복되는지에 달려 있습니다. 기본 설정의 compress() 함수를 프로바이더 토크나이저로 측정해 보면, 100개 결과를 담은 코드 검색에서 21%(17,199 → 13,597토큰), 코드베이스 탐색에서 42%(58,801 → 33,895토큰), GitHub 이슈 분류에서 30%(46,067 → 32,429토큰)를 줄였습니다. 앞서 본 SRE 사례가 네 번째 측정 시나리오로 57%를 기록했습니다. 지연 시간 벤치마크에서 반복적인 JSON 배열과 로그 줄은 90% 넘게 줄어들지만, 산문체나 이미 밀도가 높은 출력은 거의 줄어들지 않습니다. 지연 시간 중앙값은 10K 토큰 JSON 검색 결과에서 0.21ms, 100K 토큰에서 1.4ms이므로 압축 단계가 에이전트 응답 속도에 티 나게 잡힐 가능성은 낮습니다.
N=100 기준으로 공개된 정확도 검증에서는 성능 저하가 관찰되지 않았습니다. GSM8K는 0.870을 그대로 유지합니다. TruthfulQA는 0.530에서 0.560으로 올랐지만 신뢰구간 안의 변화라 유의미한 개선으로 보지는 않습니다. SQuAD v2는 19% 압축에서 97%, BFCL은 32% 압축에서 97%로 보고되었습니다.
별도 프록시 경로를 타면 입력뿐 아니라 출력까지 줄일 수 있습니다. Opus급 모델에서는 출력 토큰 단가가 입력 토큰의 다섯 배에 달합니다. 장황함 제어(verbosity steering) 기능은 시스템 프롬프트 끝에 짧은 "간결하게 답하고 컨텍스트를 되풀이하지 말라(be terse, do not restate context)"는 지시를 덧붙여, 앞에서 쌓은 캐시 프롬프트 접두사가 계속 적중하도록 유지합니다. 이 기능은 Anthropic /v1/messages와 OpenAI 호환 /v1/chat/completions, /v1/responses 경로에 적용되며, 각 경로에 동일한 output_shaper:* 라벨을 붙입니다.
크로스 에이전트 메모리는 Claude, Codex, Gemini, Grok이 공유하는 단일 저장소를 유지하면서 중복 항목을 제거합니다. headroom learn은 실패한 세션을 읽어 수정 사항을 기본값인 CLAUDE.local.md(gitignore 대상)에 기록하거나 CLAUDE.md, AGENTS.md, GEMINI.md, GROK.md에 저장합니다.
사용 방법
쓸 때
Python 앱에서 이미 OpenAI나 Anthropic 형식의 메시지 딕셔너리를 조립해 두고, 클라이언트 호출 직전에 도구 메시지와 어시스턴트 메시지만 줄이고 싶을 때입니다.
from headroom import compress

result = compress(messages, model="gpt-4o")
압축된 result.messages와 절약된 토큰 수·압축률을 돌려받으며, 기존 채팅 컴플리션 호출에 result.messages를 그대로 넘기면 됩니다.
쓸 때
이미 쓰고 있는 코딩 에이전트의 소스코드는 한 줄도 손대지 않은 채 바로 연결해 쓰고 싶을 때입니다.
headroom wrap claude로컬 프록시가 뜨고 에이전트가 Headroom을 거치도록 연결된 상태로 실행되며, 에이전트가 끝나면 프록시도 함께 종료됩니다.
쓸 때
어떤 언어로 만든 앱이든 별도 라이브러리를 임포트하지 않고 로컬 프록시로 LLM 트래픽을 보내야 할 때입니다.
headroom proxy --port 8787프록시가 8787 포트에서 대기하며 지나가는 트래픽을 압축하고, 프록시가 켜져 있는 동안 headroom dashboard로 실시간 절감 현황을 확인할 수 있습니다.
설치
uv tool install --python 3.13 "headroom-ai[all]"
pip install "headroom-ai[all]"
npm install headroom-ai
PyPI로 설치한 뒤 headroom doctor를 실행하면 라우팅이 제대로 동작하는지 확인할 수 있습니다. npm 패키지는 TypeScript SDK이므로 headroom 명령어는 들어 있지 않습니다.
잘 맞지 않는 경우
페이로드가 산문체이거나 이미 정보가 촘촘히 압축된 텍스트라면 Headroom이 잘 맞지 않습니다. 그런 글은 거의 줄어들지 않아 입력 분량이 달라지지 않기 때문입니다. 모델 호출 전 압축 단계가 아니라 리버스 엔지니어링이나 스킬 방법론이 필요한 작업에도 맞지 않습니다.
| 비교 저장소 | 해당 저장소를 고를 때 | Headroom을 고를 때 | 스타 수 |
|---|---|---|---|
| rea | 에이전트가 네이티브 바이너리 수준까지 앱 동작을 리버스 엔지니어링해야 할 때 | 에이전트는 이미 동작하고 있고 토큰 양이 문제일 때 | 468,244 |
| skills | 엔지니어의 에이전트 디렉터리에서 스킬 파일이 필요할 때 | 스킬 팩이 아니라 압축기, 프록시, MCP 서버가 필요할 때 | 327,449 |
| superpowers | 에이전트용 스킬 프레임워크와 개발 방법론이 필요할 때 | 모델 호출 전에 도구 출력을 로컬에서 압축하고 싶을 때 | 321,304 |
에이전트 트래픽에 반복적인 도구 출력, 로그, JSON이 많다면 Headroom을 설치하고, 컨텍스트가 이미 밀도 높은 산문체라면 건너뛰세요. GitHub 저장소는 스타 80,104개, 포크 6,281개, 열린 이슈 295개를 기록하고 있으며, 2026-01-07에 만들어져 2026-11-18에 마지막 푸시가 올라왔고 라이선스는 Apache-2.0입니다.
많이 묻는 질문
한 줄 명령으로 바로 연결할 수 있는 에이전트는 무엇인가요?
headroom wrap은 claude, codex, grok, copilot, cursor, aider, opencode, cline, continue, goose, openhands, openclaw, vibe, omp, droid, zcode를 지원합니다. MCP 클라이언트는 wrap 대신 headroom_compress, headroom_retrieve, headroom_stats를 호출하면 됩니다.
에이전트가 종료된 뒤에도 프록시가 계속 실행되나요?
headroom wrap은 세션 단위로 동작하므로 감싼 에이전트가 끝나면 프록시도 함께 종료됩니다. 재부팅 뒤에도 살아 있는 프록시가 필요하면 headroom deploy를, 상시 실행 서비스·예약 작업·Docker 런타임·적용 범위·프로바이더 대상을 직접 지정해야 한다면 headroom install apply를 쓰세요.
압축하는 동안 프롬프트 텍스트는 어디에 머무나요?
압축은 사용자 기기에서 실행되므로 압축을 위해 프롬프트나 파일 내용을 외부로 보내지 않습니다. CCR은 필요할 때 꺼내 쓸 수 있도록 원본을 로컬 캐시에 보관하며, HEADROOM_OFFLINE=1을 설정하면 라이브러리 실행 시 네트워크 접속을 차단합니다.
출처: GitHub 저장소 headroomlabs-ai/headroom (https://github.com/headroomlabs-ai/headroom).
'AI 스킬' 카테고리의 다른 글
| OpenMontage, 간단한 요청 한 줄로 완성 영상을 만든다 (0) | 2026.11.18 |
|---|---|
| career-ops, 이력서로 공고를 채점하고 제출할 지원서 초안을 씁니다 (0) | 2026.11.18 |
| Archify, 아이디어, 계획, 코드베이스를 대화형 다이어그램으로 (0) | 2026.11.17 |


